

Le features categoriche sono un’importante carta vincente nell’analisi dei dati, ma come trasformarle in vantaggio competitivo? Naviga con noi attraverso le strategie più efficaci per gestire queste variabili e portare il tuo modello al prossimo livello!
Conoscenze preliminari
Come Gestire le Features Categoriche
Le features categoriche richiedono un trattamento speciale perché non possono essere utilizzate direttamente in forma testuale. Questo perché i modelli di machine learning si basano su operazioni matematiche e statistiche, e trattare le features categoriche come stringhe di testo potrebbe portare a risultati inaccurati o inefficaci. Invece, è necessario trasformare le features categoriche in un formato numerico o binario che possa essere interpretato correttamente.
In questa sezione analizziamo due delle tecniche più utilizzate: Label encoding e one-hot encoding.
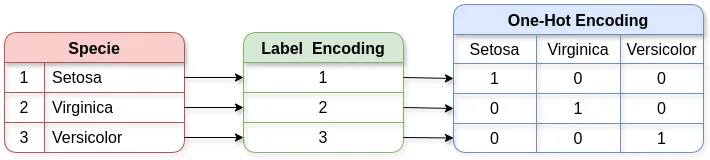
1. Label Encoding
Il label encoding è una tecnica utilizzata per convertire le categorie in numeri.
Immagina di avere una colonna di dati con le categorie “Rosso”, “Verde” e “Blu”. Con il label encoding, assegniamo un numero a ciascuna categoria: ad esempio, “Rosso” diventa 1, “Verde” diventa 2 e “Blu” diventa 3. In questo modo, le categorie sono rappresentate da numeri che i modelli di machine learning possono comprendere e utilizzare per fare previsioni.
Questo codice dimostra l’utilizzo del LabelEncoder per convertire le categorie presenti nella colonna “variety” del dataset iris in numeri. È importante notare l’utilizzo di joblib per salvare l’encoder creato, in quanto consente di applicare sempre lo stesso criterio di conversione anche su nuovi dati, garantendo coerenza e riproducibilità nell’analisi dei dati.
Da notare che utilizzando il label encoding si attribuisce un significato numerico alle categorie, il che potrebbe portare il modello a interpretare erroneamente un ordine di grandezza tra di esse. Ad esempio, nel caso riportato, assegnando i valori 0, 1 e 2 rispettivamente alle categorie ‘Setosa’, ‘Versicolor’ e ‘Virginica’, il modello potrebbe erroneamente dedurre un ordine gerarchico tra queste categorie, quindi definire ‘Virginica’ maggiore di ‘Setosa’ e ‘Versicolor’. Questa deduzione non avrebbe senso, in quanto le categorie non sono ordinate o confrontabili in modo naturale.
Quindi, per evitare confusioni, è preferibile applicare il label encoding alle variabili target o di output, dove è richiesta una rappresentazione numerica, mentre per le variabili di input, come le features categoriche, è preferibile utilizzare tecniche come l’one-hot encoding o altri metodi che non introducono un ordine artificiale tra le categorie
2. One-hot Encoding
L’one-hot encoding è una tecnica che trasforma le features categoriche in un formato numerico che i modelli di machine learning possono comprendere facilmente.
Immagina di avere una colonna “colore” con le categorie “rosso”, “verde” e “blu”. Con l’one-hot encoding, trasformiamo questa colonna in tre nuove colonne: “rosso”, “verde” e “blu”. Ogni riga del dataset avrà un valore “1” nella colonna corrispondente al colore della riga e “0” nelle altre colonne, come mostrato nella formula qui sotto.
In questo modo, il modello tiene in considerazione l’impatto individuale di ciascun colore sull’output previsto, consentendo di valutare come il colore influisca sulla variabile dipendente. Un esempio esplicativo di regressione viene mostrato di sotto, in quanto evidenzia la capacità del modello di trattare ogni colore come una variabile distinta nella predizione dell’output, migliorando così le sue capacità predittive.
Il codice sotto riportato illustra un metodo comune per applicare l’one-hot encoding su colonne di un DataFrame. La colonna ‘encoded.variety‘ riflette l’applicazione del label encoding, in cui le categorie sono convertite in valori numerici. Le successive tre colonne rappresentano invece l’one-hot encoding, una tecnica in cui ogni categoria viene rappresentata da una colonna binaria. Questa rappresentazione aiuta a distinguere chiaramente le differenze tra le due tecniche di encoding e offre una visione più approfondita di come i dati categorici vengono trasformati per l’analisi da parte dei modelli di machine learning.


