
Ti sei mai chiesto come rendere più comprensibili i dati complessi? Scopri come la Principal Component Analysis può semplificare i dataset ad alta dimensionalità, mantenendo solo le informazioni essenziali, con spiegazioni intuitive, esempi pratici e illustrazioni!

Letture Consigliate
Selezione delle Features: Dal Concetto alla Pratica
Introduzione alla Principal Component Analysis
I dataset con molte variabili possono essere difficili da analizzare: troppe caratteristiche rendono quasi impossibile individuare schemi o tendenze. È qui che entra in gioco la PCA. La PCA aiuta a ridurre il numero di caratteristiche mantenendo solo le informazioni più rilevanti, rendendo i dati più facili da analizzare e visualizzare.
Questa guida è divisa in due parti: un’introduzione intuitiva alla PCA, seguita da una spiegazione pratica con formule, codice ed esempi.
Parte 1: L’Idea Dietro la Principal Component Analysis
In questa sezione affrontiamo la PCA da un punto di vista intuitivo, cercando di fissare bene in mente il concetto.
Perché Abbiamo Bisogno della PCA?
Analizzare dati con molte variabili può rendere difficile vedere il quadro generale. Ecco perché la PCA è utile:
- Riduzione del Rumore: Troppe caratteristiche possono aggiungere rumore, nascondendo schemi importanti. La PCA aumenta il rapporto segnale-rumore concentrandosi sulle direzioni più informative.
- Migliori Prestazioni nei Modelli di Apprendimento: Troppe caratteristiche rallentano i modelli e possono ridurre la precisione. Riducendo il numero di variabili, la PCA rende l’addestramento più veloce senza perdere informazioni rilevanti.
- Visualizzazione: Con dati ad alta dimensionalità, è difficile vedere tendenze. La PCA riduce i dati a 2D o 3D, rendendo i pattern molto più chiari.
L’Idea Chiave: Catturare la Direzione di Massima Varianza
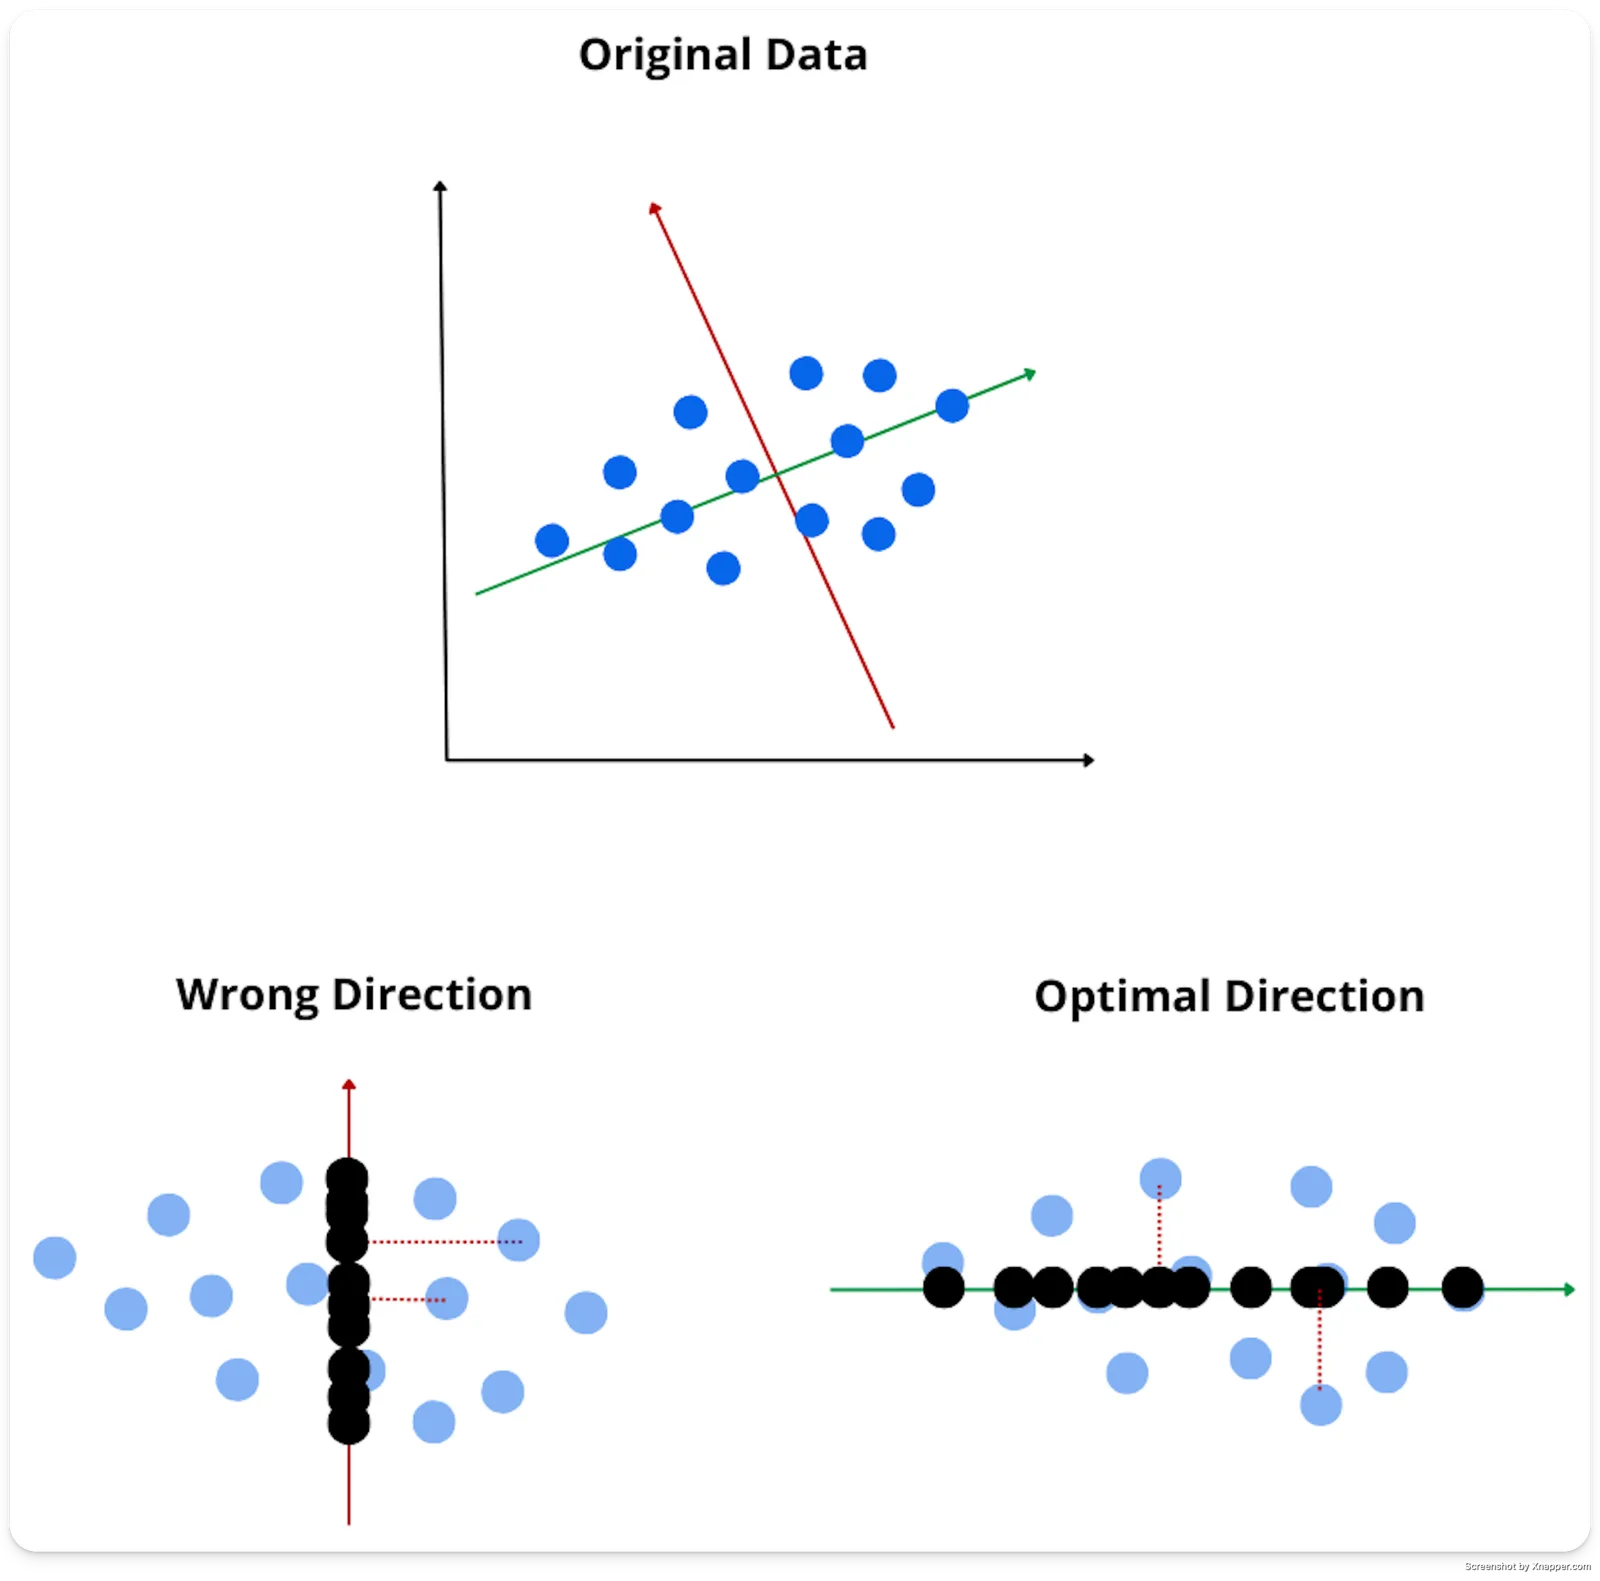
Il concetto centrale della PCA è identificare la direzione con la maggior varianza: l’asse che meglio rappresenta la distribuzione dei dati. Perché? Perché una direzione con alta varianza rivela i pattern fondamentali, mentre una bassa varianza riflette spesso ridondanza o rumore.
Guarda l’immagine qui sotto. Quando proiettiamo i dati nella direzione sbagliata, i punti si addensano, diventando difficili da distinguere: così, perdiamo informazioni preziose. Ma se scegliamo la direzione verde (quella con la maggior varianza), i punti restano ben separati, anche in dimensioni ridotte. Questo dimostra che maggiore varianza significa maggiori informazioni preservate.
Comprendere Componenti Principali e Varianza
Ogni componente principale in PCA rappresenta una nuova direzione nei dati, catturando una certa quantità di varianza o “dispersione”. Ma perché la varianza è così importante?
Consideriamo un problema di classificazione. Se tutti i punti dati sono molto vicini tra loro (senza varianza), è quasi impossibile distinguerli: non contengono informazioni significative. Al contrario, se i punti sono più dispersi (alta varianza), le differenze tra loro diventano chiare, fornendo informazioni preziose per identificare schemi.
Esempio Intuitivo:
Immagina di classificare studenti in base ai voti. Se ogni studente ottiene lo stesso voto in ogni test, non puoi imparare nulla di utile da questi dati: non c’è variazione su cui fare affidamento per la classificazione. Ma se i voti variano, la distribuzione (varianza) ci indica chi eccelle o ha difficoltà, permettendoci di vedere pattern unici e fare previsioni migliori.
In PCA:
- Il primo componente principale cattura la direzione con la maggior varianza, trattenendo il pattern fondamentale o il “segnale” dei dati.
- I componenti successivi catturano sempre meno varianza, rappresentando infine solo rumore.
Passare da 2D a Dimensioni Maggiori
Questo ragionamento si estende facilmente: la PCA può ridurre un dataset da dimensioni più alte, come 50D a 2D, catturando i pattern fondamentali e rendendo i dati più facili da analizzare e visualizzare.
Limitazioni con Random Forests (RF)
Alcuni modelli, come le Foreste Casuali (RF), funzionano meglio quando ogni caratteristica è distinta. Poiché le componenti della PCA sono combinazioni delle caratteristiche originali, usarle in RF potrebbe produrre risultati imprevedibili. Per RF, è generalmente meglio mantenere le caratteristiche originali.
Parte 2: Aspetti Pratici della Principal Component Analysis
In questa sezione vedremo a livello pratico, sia matematico che di codice come usare la Principal Component Analysis.
Come Funziona la PCA: Passo per Passo
La PCA si basa su autovettori e autovalori, che forniscono le direzioni e l’importanza della varianza nei dati.
1. Centrare i Dati: Sottrarre la media da ciascuna caratteristica per centrare i dati intorno allo zero:
Standardizzare i dati è essenziale prima di applicare la PCA, per garantire che tutte le caratteristiche contribuiscano in modo equo. Senza standardizzazione, le caratteristiche con scala più ampia possono dominare le componenti principali, alterando i risultati e nascondendo pattern nelle variabili su scala minore.
2. Calcolare la Matrice di Covarianza: Questa matrice mostra come le caratteristiche variano insieme:
3. Calcola Autovalori e Autovettori: Risolvi per gli autovalori e gli autovettori (v) della matrice di covarianza.
Ogni autovettore (v) rappresenta una direzione delle componenti principali, e il suo autovalore () indica la quantità di varianza in quella direzione.
4. Selezionare le Componenti Principali: Ordinare gli autovettori in base agli autovalori in ordine decrescente, e selezionare i più rilevanti. Questo passaggio riduce il numero di dimensioni mantenendo le direzioni di varianza più significative.
5. Trasformare i Dati: Proiettare i dati originali sulle componenti principali selezionate. Se manteniamo k componenti, la matrice di trasformazione W conterrà i k autovettori come colonne:
Qui, X_PCA rappresenta il dataset finale ridotto, trasformato nei nuovi assi definiti dalle componenti principali.
Esempio di Codice: Applicare PCA a Dati Reali
Questo esempio mostra come la PCA trasforma i dati, con la varianza spiegata che diminuisce da una componente all’altra.
Applicazioni Pratiche della PCA
- Compressione delle Immagini: Le immagini contengono migliaia di pixel come caratteristiche. La PCA può ridurre la dimensione di questi pixel mantenendo i dettagli importanti, rendendola un potente strumento per comprimere e archiviare immagini senza perdita significativa di qualità.
- Genomica: I dati genomici includono migliaia di geni come caratteristiche per ogni campione. La PCA aiuta a identificare i geni più critici che determinano variazioni, riducendo la complessità dei dati e facilitando la ricerca, ad esempio per identificare geni associati a specifiche malattie.
- Segmentazione dei Clienti: In ambito e-commerce o marketing, i dataset possono contenere numerosi attributi per ciascun cliente, come età, località, cronologia degli acquisti e preferenze. La PCA identifica gli attributi più rilevanti per il clustering, rendendo la segmentazione più veloce e approfondita per un targeting più efficace.
- Analisi Finanziaria: In finanza, la PCA può semplificare l’analisi di numerosi indicatori economici, prezzi azionari o caratteristiche di asset, rivelando i pattern che influenzano la variazione sui mercati. Questo aiuta nell’ottimizzazione del portafoglio e nella gestione del rischio concentrandosi sui componenti principali che influenzano i rendimenti.
- Elaborazione del Linguaggio Naturale (NLP): I dati testuali sono generalmente rappresentati come vettori ad alta dimensionalità. La PCA può ridurre la dimensione delle parole o degli embedding dei documenti, consentendo ai modelli NLP di lavorare con input più piccoli, più veloci e meno complessi senza perdere informazioni contestuali chiave.
Conclusione
La PCA è uno strumento versatile che rende i dati ad alta dimensionalità più gestibili e facilmente interpretabili concentrandosi sui pattern più informativi. Catturando le direzioni con la maggior varianza, la PCA mantiene le informazioni essenziali filtrando il rumore. Questa semplificazione è utile in vari campi, dall’elaborazione delle immagini alla genomica e alla finanza, facilitando l’esplorazione dei dati, l’addestramento efficiente dei modelli e la visualizzazione.
Che tu stia preparando dati per modelli di machine learning o cercando di visualizzare dataset complessi, la PCA è una tecnica fondamentale per ogni data scientist.


